SQL vs NoSQL : pourquoi cette image me dérange
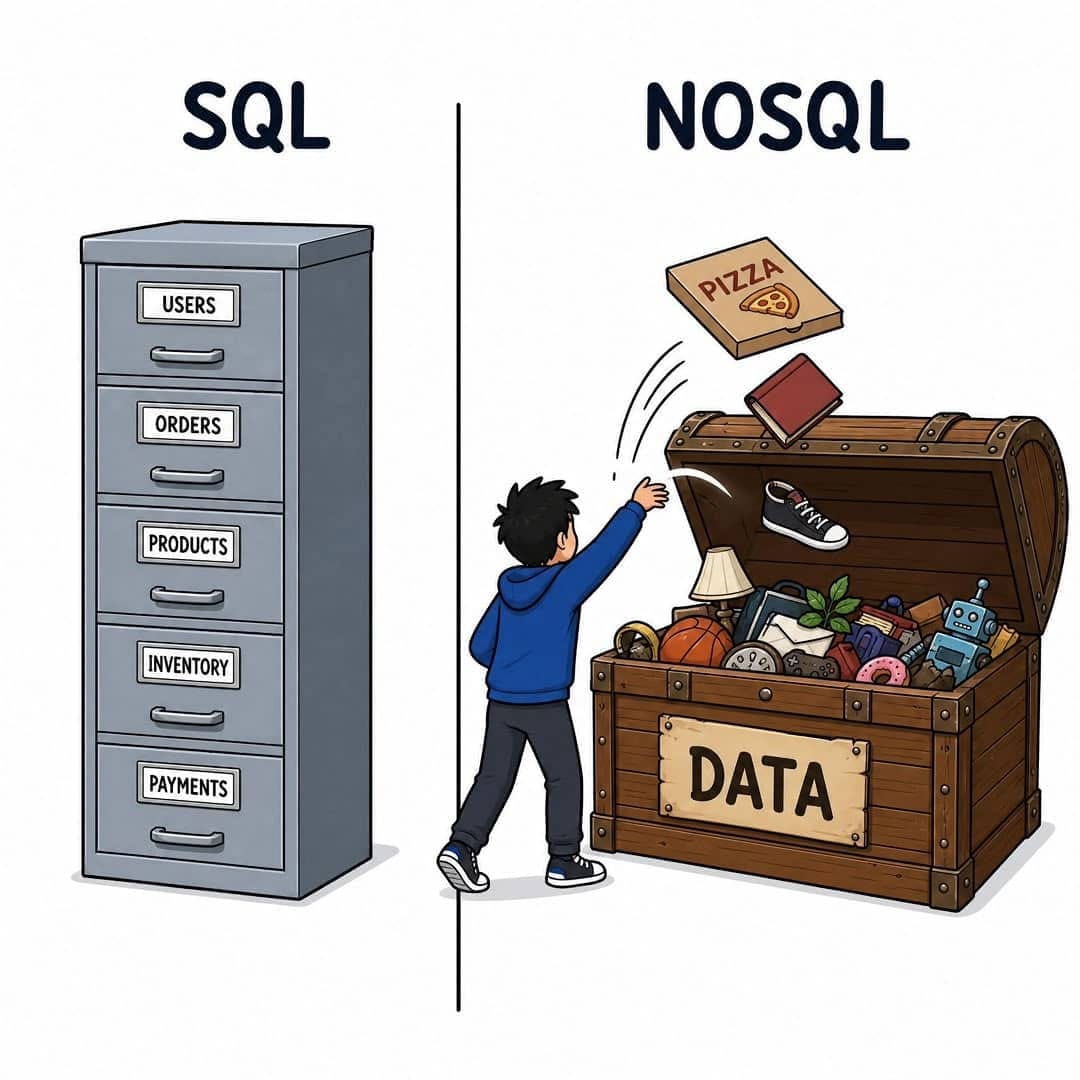
Je suis tombé récemment sur une image qui comparait SQL et NoSQL.
À gauche, on avait quelque chose de très propre : des tables bien rangées, des colonnes, des relations… bref, tout était à sa place.
À droite, c’était presque l’inverse. Des données dans tous les sens, sans organisation apparente. L’image donnait vraiment l’impression que SQL, c’était la maison bien rangée, et NoSQL… la chambre après une semaine sans faire le ménage.
Sur le coup, j’ai trouvé l’image assez drôle.
Mais en y réfléchissant un peu, je me suis posé une question :
Est-ce que c’est vraiment ça, NoSQL ?
Parce que lorsqu’on commence à travailler avec les bases de données, cette représentation peut facilement nous faire croire que SQL signifie « structuré » et que NoSQL signifie « pas structuré ».
Et pourtant, ce n’est pas vraiment ça.
NoSQL ne veut pas dire « sans structure »
Prenons une base orientée documents comme MongoDB.
On peut très bien avoir des données parfaitement structurées :
{
  "name": "Christ",
  "age": 24,
  "skills": ["Python", "SQL", "Go"]
}
Et un autre document peut avoir une structure légèrement différente :
{
  "name": "Jean",
  "skills": ["Java", "Spring"]
}
Le fait que les deux documents ne possèdent pas exactement les mêmes champs ne signifie pas que les données sont désorganisées.
C’est simplement une autre manière de gérer leur structure.
Et c’est là que je trouve la comparaison intéressante :
avoir une structure et avoir un schéma rigide, ce n’est pas la même chose.
Une base NoSQL peut donc être très bien pensée, avec des règles, des conventions et une structure cohérente.
La différence est plutôt dans la manière dont cette structure est imposée et gérée.
Mais NoSQL, ce n’est même pas une seule chose
Il y a aussi un autre problème avec ce genre d’image.
On parle souvent de « NoSQL » comme s’il s’agissait d’une technologie unique.
Mais MongoDB n’est pas Redis.
Redis n’est pas Cassandra.
Cassandra n’est pas Neo4j.
On retrouve plusieurs grandes familles de bases NoSQL : bases orientées documents, bases clé-valeur, bases orientées colonnes ou encore bases orientées graphes.
Leurs modèles de données et leurs usages peuvent être complètement différents.
Donc mettre tout le NoSQL dans un même coffre rempli d’objets n’est pas forcément la meilleure manière de l’expliquer.
Alors, où se trouve réellement la différence ?
C’est probablement la partie qui m’intéresse le plus.
La comparaison n’est pas vraiment :
SQL = données bien rangées
contre
NoSQL = données mal rangées.
La question est plutôt :
À quel moment est-ce qu’on impose la structure ?
Dans une base relationnelle, on définit généralement un schéma avant d’insérer les données.
On sait quelles colonnes existent, quels types elles doivent avoir et quelles relations existent entre les différentes tables.
La base joue donc un rôle important dans le respect de cette structure.
Avec une base NoSQL, on peut avoir beaucoup plus de souplesse dans la forme des données.
Mais cette souplesse ne fait pas disparaître la structure.
Elle déplace simplement une partie de la responsabilité.
Et c’est là qu’il faut faire attention.
Parce qu’une base qui nous laisse beaucoup de liberté ne signifie pas que notre application doit faire n’importe quoi.
Au contraire, plus on a de flexibilité, plus il faut savoir quelles règles on veut réellement appliquer.
SQL et NoSQL sont-ils vraiment opposés ?
C’est peut-être là que cette image devient encore plus intéressante.
On a longtemps présenté SQL et NoSQL comme deux mondes complètement opposés.
D’un côté, les tables et les relations.
De l’autre, les documents et la flexibilité.
Mais dans la pratique, la frontière est beaucoup moins nette.
Des bases relationnelles comme PostgreSQL permettent par exemple de manipuler des données JSON/JSONB.
De leur côté, certaines bases NoSQL proposent des mécanismes de requêtes qui peuvent rappeler SQL.
Les deux approches ont donc aussi évolué.
Et finalement, je trouve qu’on perd quelque chose lorsqu’on présente le choix comme un simple :
SQL ou NoSQL ?
La vraie question devrait plutôt être :
De quoi mon application a-t-elle besoin ?
Comment mes données sont-elles structurées ?
Est-ce que cette structure va beaucoup évoluer ?
Comment vais-je interroger ces données ?
Est-ce que les relations entre les données sont importantes ?
Quelle quantité de données vais-je gérer ?
Quelles contraintes dois-je absolument garantir ?
Et surtout, quel problème est-ce que j’essaie réellement de résoudre ?
Et si on arrêtait justement de choisir entre les deux ?
C’est en continuant à réfléchir à cette question que je suis tombé sur SurrealDB.
Je trouve que ce projet est intéressant dans le contexte de cette discussion, justement parce qu’il remet en question cette séparation très nette entre SQL et NoSQL.
SurrealDB se présente comme une base de données multi-modèle. Elle permet notamment de travailler avec des données de type document, relationnel et graphe, mais aussi avec des données vectorielles ou temporelles.
Et le plus intéressant, c’est son langage : SurrealQL.
À première vue, on retrouve quelque chose de très familier :
SELECT name
FROM user
WHERE age >= 18;
On reconnaît immédiatement la logique SQL.
Mais le langage permet également de travailler avec des relations entre les données et d'exploiter des modèles qui vont au-delà des simples tables relationnelles.
C’est là que je trouve l’approche intéressante.
On peut avoir des données qui ressemblent à des documents, tout en conservant une manière de les interroger qui rappelle SQL, et représenter les relations comme de véritables liens entre les enregistrements.
Cela ne signifie pas pour autant que SurrealDB « remplace » SQL ou NoSQL.
Ce n’est pas vraiment le sujet.
Ce qui m'intéresse, c'est plutôt ce que cette approche nous fait comprendre.
Si des outils peuvent proposer plusieurs modèles de données dans un même moteur, alors peut-être que la question « SQL ou NoSQL ? » est finalement un peu trop simpliste.
La vraie question serait peut-être :
« De quel modèle ai-je besoin pour mes données ? »
Finalement, cette image n’est pas complètement fausse
Je ne dirais pas que cette image est complètement fausse.
Elle essaie simplement de simplifier énormément les choses.
Oui, SQL est généralement très structuré.
Oui, NoSQL peut apporter beaucoup plus de flexibilité.
Mais flexibilité ne veut pas dire désordre.
Et surtout, SQL et NoSQL ne sont pas forcément deux camps qui doivent rester séparés.
Il existe plusieurs modèles de bases de données, plusieurs façons de structurer les données et de plus en plus d'outils qui cherchent à rapprocher ces approches.
C’est justement ce que je retiens de cette image.
Parce qu’au début, moi aussi, j’aurais probablement regardé cette comparaison en me disant :
> SQL est organisé. NoSQL est le bazar.
Aujourd’hui, je la regarderais plutôt en me demandant :
Pourquoi est-ce qu’on confond autant structure et schéma ?
Et surtout :
Pourquoi faudrait-il forcément choisir un camp ?
Peut-être qu’au fond, le plus important n’est pas de savoir si une base est SQL ou NoSQL.
C’est de comprendre comment nos données doivent être organisées, comment elles vont évoluer et comment notre application va réellement les utiliser.